Carnet de formation IA · 2026-09-11
Normaliser, puis indexer : mon cours m'apprend à réparer ce qu'il vient de casser
Trois techniques présentées côte à côte, sur le même plan, comme si elles allaient dans le même sens. Deux d'entre elles tirent en sens inverse, et personne ne le dit.
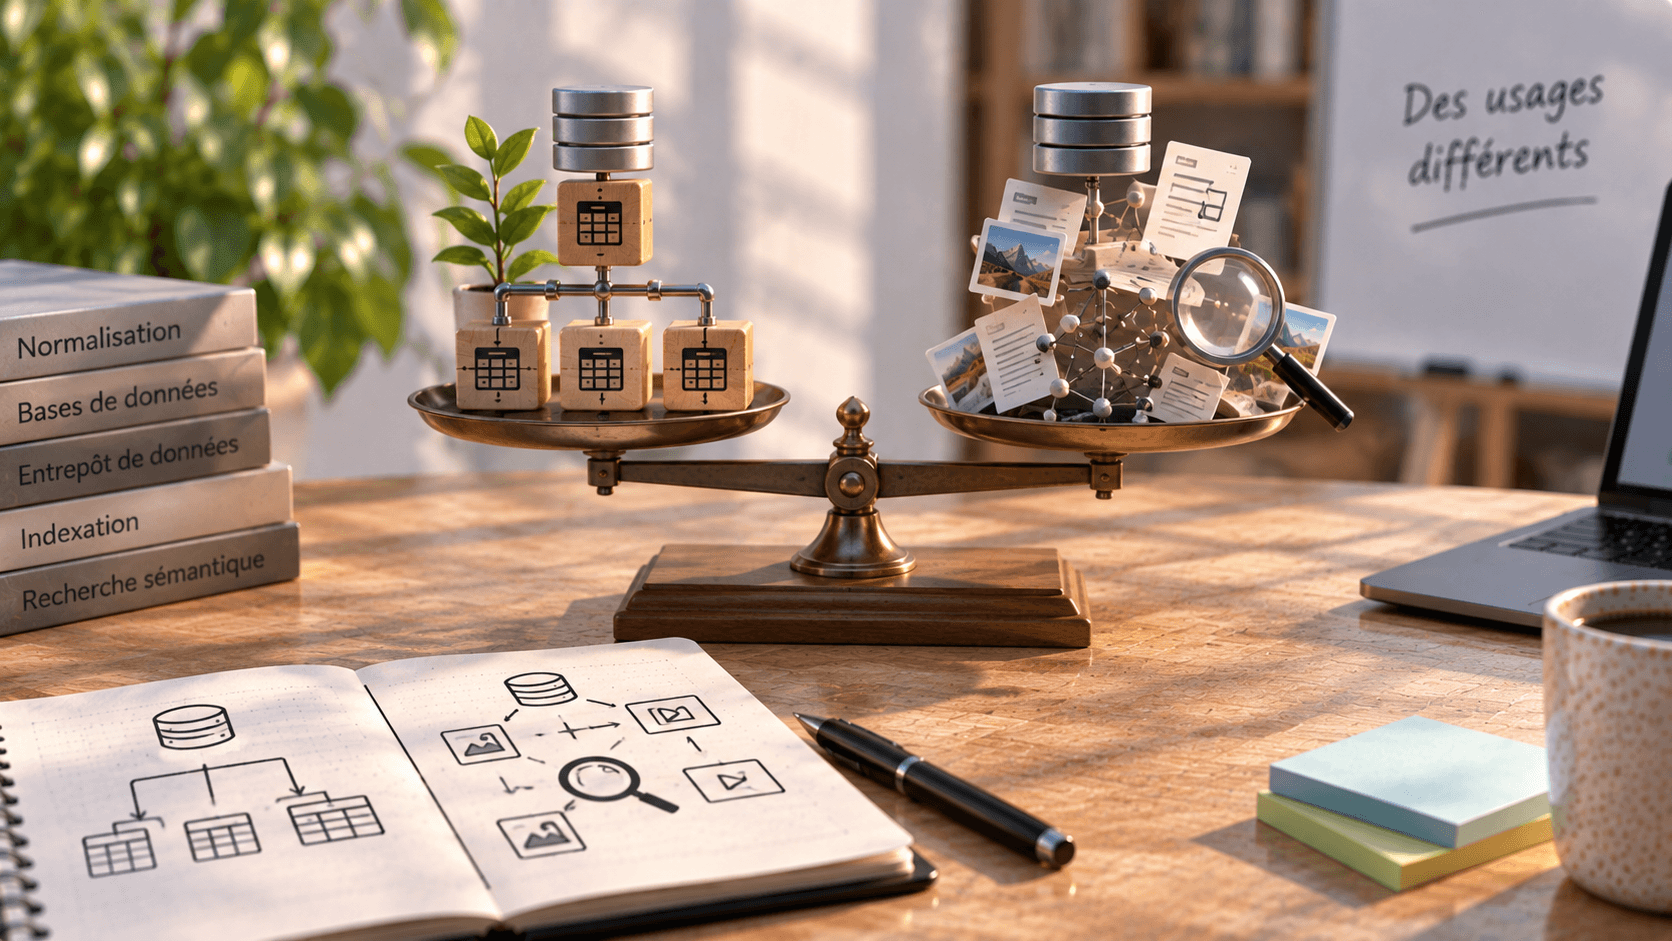
Ce que je croyais
Que structurer une base de données consistait à appliquer trois bonnes pratiques.
Le module est explicite : la structuration repose sur trois techniques. La normalisation, qui organise logiquement pour éliminer la redondance. L'indexation, qui optimise techniquement les accès. La modélisation relationnelle, qui conçoit le modèle conceptuel.
Trois puces, présentées dans cet ordre, sur le même plan. Chacune a ensuite sa section, avec son exemple et ses avantages. La normalisation élimine les anomalies, optimise le stockage, apporte de la flexibilité. L'indexation accélère les requêtes. Le modèle conceptuel donne une vue d'ensemble.
Que du positif, trois fois. Je les ai apprises comme trois outils à connaître.
Quatre mots pour lire la suite
- Normalisation --- découper une table en plusieurs pour qu'une information ne soit stockée qu'à un seul endroit.
- Jointure --- l'opération qui recolle les tables au moment de lire, pour reconstituer l'information éclatée.
- Index --- une structure supplémentaire qui permet de retrouver directement une ligne sans parcourir toute la table.
- Dénormalisation --- le geste inverse de la normalisation : accepter volontairement de dupliquer une information pour éviter des jointures. Le mot n'apparaît nulle part dans mon cours.
Ce qui m'a fait buter
L'exemple de normalisation du support est très clair. Une table « Transactions » contient nom du client, adresse, nom du produit, catégorie, prix, date. On la découpe en trois : Clients, Produits, Transactions. Avantage annoncé : si un client déménage, seule la table Clients est modifiée, ce qui évite les incohérences.
Impeccable. Je l'ai refait à la main, ça tient.
Puis vient la section indexation, et son exemple : dans une table Employés de plusieurs milliers de lignes, une recherche filtrée sur la colonne Nom peut devenir lente ; créer un index accélère fortement les requêtes.
Et là je me suis arrêté, avec une question idiote.
Pourquoi la recherche est-elle lente ?
Le cours ne le dit pas. Dans son exemple, la réponse est assez simple : sans index adapté, le moteur peut devoir parcourir beaucoup de lignes pour trouver celles qui correspondent au nom recherché. Cela peut arriver indépendamment de la normalisation.
Mais le paragraphe précédent venait de m'apprendre autre chose : normaliser peut aussi multiplier les jointures nécessaires pour certaines lectures. L'indexation ne « répare » donc pas la normalisation, et les deux ne forment pas une relation simple de cause à effet. En revanche, elles participent au même arbitrage : organiser les données pour préserver leur cohérence a un coût sur certains accès ; accélérer ces accès a lui-même un coût sur le stockage et les écritures.
C'est cette relation que la liste à trois puces rend invisible. Les techniques ne s'annulent pas, mais elles ne sont pas non plus trois bénéfices indépendants que l'on empile gratuitement.
Comment j'ai cherché
J'ai voulu vérifier que je ne me faisais pas un film, parce que je n'ai pas d'expérience de production sur ces sujets.
Le compromis existe et il a un nom. C'est en cherchant que j'ai découvert le mot « dénormalisation », qui n'apparaît nulle part dans mon support. C'est le geste inverse : dupliquer volontairement une information pour éviter d'avoir à faire une jointure à chaque lecture.
Ce n'est pas une mauvaise pratique de débutant, c'est une décision assumée dans certains cas --- typiquement quand on lit beaucoup plus souvent qu'on écrit. De nombreux modèles d'entrepôts de données, notamment les schémas en étoile, acceptent davantage de dénormalisation : ils sont conçus pour faciliter les lectures et les analyses.
Ce qui m'a frappé, c'est que mon propre cours enseigne l'entrepôt de données deux leçons plus loin, et le décrit comme « orienté sujet », avec des données consolidées venues de plusieurs sources. C'est une description de structure dénormalisée. Le module normalise dans une leçon et dénormalise dans une autre, sans jamais nommer l'opposition.
La bonne question n'est pas « faut-il normaliser ». C'est « pour quel usage ». J'ai fini par formuler la règle qui manquait, et elle est plus simple que je ne le craignais : la normalisation optimise l'écriture et la cohérence ; la dénormalisation optimise la lecture. Une base transactionnelle --- des commandes qui arrivent, des stocks qui bougent --- écrit sans arrêt, donc elle normalise. Une base d'analyse lit sans arrêt, donc elle dénormalise.
Et une fois qu'on a dit ça, la distinction que le cours enseigne par ailleurs entre base relationnelle et entrepôt de données cesse d'être une liste de deux produits pour devenir une conséquence de cet arbitrage. C'est le même contenu, mais organisé par une question au lieu de l'être par une nomenclature.
Ce que coûte un index. J'ai poussé un peu plus loin, parce que si l'index est gratuit, la question ne se pose pas. Il ne l'est pas : un index occupe de l'espace, et il doit être mis à jour à chaque écriture. Sur une table très sollicitée en écriture, multiplier les index ralentit ce qu'on voulait accélérer.
Le cours mentionne l'index unique et l'index composé comme deux « types d'index utiles ». Il ne dit jamais qu'un index se paie. Encore une fois : liste d'avantages, pas d'arbitrage.
Ce que ça change
Une façon de lire les listes. C'est le vrai enseignement de cet épisode, et il déborde largement les bases de données.
Une liste à puces pose ses éléments sur le même plan. C'est son intérêt et c'est son défaut : quand deux éléments s'opposent ou se compensent, elle rend cette relation invisible. « Normalisation, indexation, modélisation » se lit comme trois choses à faire. La réalité est plus intéressante : une décision sur l'organisation des données, une autre sur la manière d'accélérer certains accès --- avec son propre coût --- et une méthode de conception qui aide à structurer l'ensemble.
Je regarde désormais les listes de mes fiches avec cette question : est-ce que ces éléments sont vraiment sur le même plan, ou est-ce que la liste écrase une relation entre eux ? J'en ai déjà repéré deux autres, et je soupçonne que c'est fréquent --- la puce est le format par défaut des supports de formation.
Une question à poser sur tout schéma de base. Avant de discuter du modèle : lit-on plus souvent qu'on écrit, ou l'inverse ? Tout en découle. Je ne l'aurais pas posée il y a un mois, j'aurais discuté des tables.
Une nuance sur ma propre critique. Le cours a raison de commencer par la normalisation. C'est la discipline de base, et dénormaliser sans l'avoir comprise ne produit pas un entrepôt de données, ça produit une table sale. L'ordre pédagogique est bon. Ce qui manque, c'est la phrase qui dit qu'il existe un mouvement inverse et à quelle condition on l'emploie --- une phrase, pas un chapitre.
C'est une chose que je remarque de plus en plus dans mes supports : ils sont rarement faux. Ils sont souvent incomplets d'exactement une phrase, celle qui dirait à quoi le contenu s'oppose.
Rattachement au référentiel
Cet épisode relève du sous-bloc BC2.1 --- De l'idée au projet IA : détecter les opportunités et construire la démarche, dans le bloc 2 du titre RNCP40875 : choisir une structure de stockage en fonction du profil d'usage est un arbitrage de conception, au même titre que le choix d'un modèle. Il croise le socle data du bloc pour la partie modélisation.
Prochain épisode : une étude de cas qui se termine par un e-mail à 19 h avec 10 % de remise.
Passer de la réflexion à la situation réelle
Ce sujet ressemble à quelque chose que vous vivez ?
Vous pouvez me décrire le contexte, ce qui résiste et ce qui devrait devenir plus clair. Nous verrons simplement si mon approche peut être utile.
Voir comment je peux aiderLes commentaires sont hébergés par Giscus et GitHub. Ils ne sont chargés qu’à votre demande.