Carnet de formation IA · 2026-09-15
Un e-mail à 19 h avec 10 % de remise
L'étude de cas de mon module de data mining déroule six étapes méthodologiques pour aboutir à une relance de panier abandonné. J'ai voulu savoir ce que la méthode avait apporté.
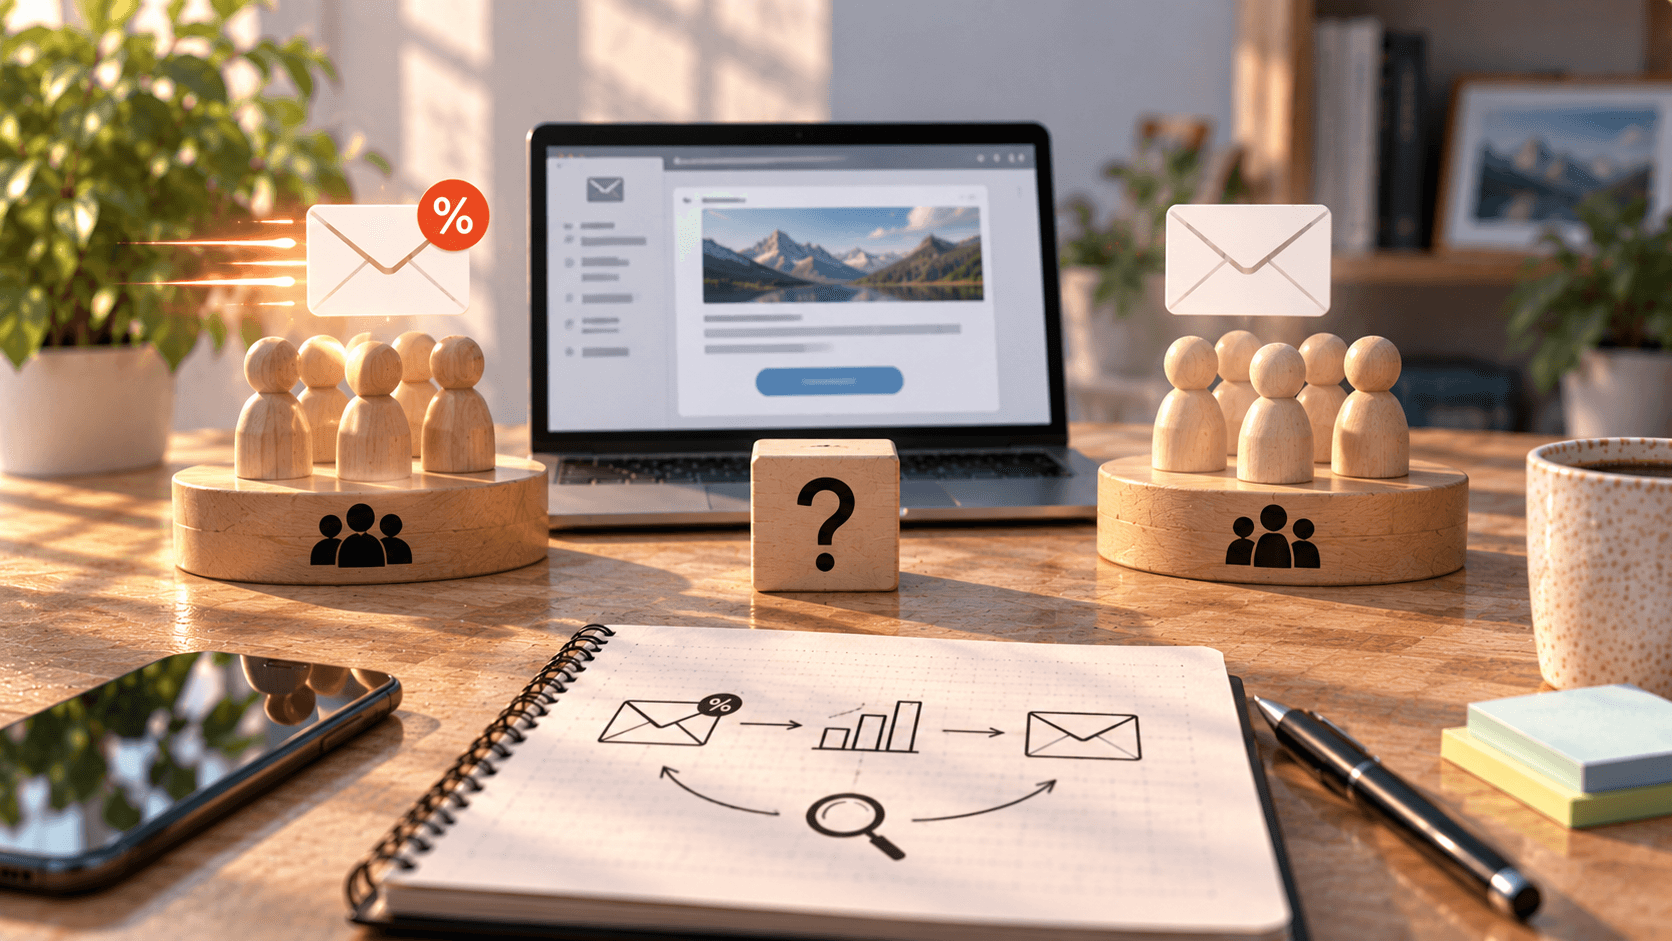
Ce que je croyais
Que CRISP-DM était le squelette d'un projet de data mining, et qu'il suffisait de le connaître.
Le modèle est propre : six étapes. Comprendre le projet, comprendre les données, les préparer, modéliser, évaluer, déployer. Le cours insiste sur le fait que le cycle est itératif --- l'évaluation peut renvoyer à la modélisation, qui peut renvoyer à la préparation.
Puis vient l'étude de cas, sur un site e-commerce appelé SportInter. On rassemble les données : historiques d'achats, parcours web, abandons de panier. On observe que les visiteurs passent cinq minutes sur les chaussures de course et deux sur les t-shirts. Les algorithmes identifient un profil type, le « coureur amateur », qui visite le soir. Décision finale : un e-mail ciblé envoyé à 19 h, pendant le pic de connexion, avec 10 % de remise sur le panier abandonné et des recommandations d'accessoires.
J'ai trouvé l'exemple pédagogique. Il relie bien les trois actions de terrain --- collecter, analyser, interpréter --- aux six étapes du modèle.
Quatre mots pour lire la suite
- CRISP-DM --- un modèle standard en six étapes qui décrit le cycle de vie d'un projet d'exploration de données.
- Baseline --- le point de comparaison : ce qu'on obtiendrait sans le dispositif qu'on met en place. Sans elle, aucun résultat n'est interprétable.
- Test A/B --- envoyer le dispositif à une moitié des utilisateurs et pas à l'autre, pour mesurer l'écart réellement causé par lui.
- Effet de sélection --- le fait de cibler les gens qui auraient de toute façon acheté, et de s'attribuer leur achat.
Ce qui m'a fait buter
J'ai relu la conclusion de l'étude de cas trois fois, avec une gêne que je n'arrivais pas à nommer.
Puis je l'ai formulée, et elle est brutale : qu'est-ce que CRISP-DM a réellement ajouté à une intuition qu'un responsable e-commerce aurait probablement déjà eue ?
Relancer les paniers abandonnés avec une remise est une pratique très courante en e-commerce. Envoyer au moment où les gens sont connectés, c'est du bon sens. Recommander des accessoires liés au produit, c'est une pratique standard depuis vingt ans.
Alors qu'est-ce que les six étapes ont apporté ?
La question m'a paru presque déloyale au moment où je l'ai écrite. Un cas d'école est simplifié, c'est normal, on ne va pas reprocher à un exemple d'être un exemple. Mais je l'ai gardée, parce qu'elle en ouvrait une autre, plus utile : à quoi reconnaît-on qu'un projet de data mining a servi à quelque chose ?
Et là je me suis aperçu que ni le cours, ni moi, n'avions de réponse.
Comment j'ai cherché
Ce que l'exemple ne contient pas. J'ai listé ce qu'il faudrait pour que la conclusion soit défendable.
Il n'y a pas de point de comparaison. On ne sait pas quel était le taux de récupération des paniers avant, ni ce que donnerait la même relance sans ciblage. Sans ça, si la campagne récupère 12 % des paniers, personne ne peut dire si c'est bien.
Il n'y a pas de mesure de l'effet propre. Envoyer une remise de 10 % à des gens qui avaient déjà mis des chaussures dans leur panier, c'est cibler des gens dont une partie serait peut-être revenue seule. Sans groupe témoin comparable qui ne reçoit pas la relance, on ne peut pas distinguer correctement l'effet de la campagne des achats qui auraient eu lieu de toute façon. Et si l'on veut savoir ce qui fonctionne précisément --- la remise, l'heure d'envoi, la personnalisation ou leur combinaison --- il faut aller plus loin qu'un simple « campagne contre rien » et comparer plusieurs variantes.
Il n'y a pas de coût. Dix pour cent de remise, c'est une marge. Sur un panier moyen à 80 €, huit euros par commande récupérée. Si la relance récupère des gens qui seraient revenus, c'est huit euros perdus par commande. Le calcul n'est nulle part.
Et il n'y a pas d'étape 6 réelle. Le cours dit que le déploiement comprend le suivi des performances et les améliorations continues. L'étude de cas s'arrête à l'envoi de l'e-mail.
Ce que j'ai compris sur le cycle. Le support insiste sur le caractère itératif de CRISP-DM. Mais son propre exemple est parfaitement linéaire : on collecte, on analyse, on décide, terminé. Aucune boucle.
C'est logique, parce qu'une boucle suppose qu'on ait mesuré quelque chose. On ne peut revenir de l'évaluation vers la modélisation que si l'évaluation a produit un chiffre qui déçoit. Sans mesure, il n'y a pas de retour possible --- le cycle se réduit à une liste d'étapes qu'on parcourt une fois.
Autrement dit : ce n'est pas la méthode qui rend un projet itératif, c'est le dispositif de mesure. Le modèle en six étapes ne boucle que si on a construit de quoi le faire boucler, et cette construction n'est pas dans le modèle.
Le lien avec ce que j'écrivais sur les métriques. J'avais listé quatre questions à poser devant un chiffre de performance : précision de quoi, comparé à quoi, mesuré comment, à quel seuil. La deuxième --- comparé à quoi --- est exactement celle qui manque ici, et c'est celle que j'avais notée comme « l'omission qui m'a le plus frappé, parce qu'elle est presque toujours là ».
Elle est là aussi. Deux modules différents, deux mois d'écart, même trou.
Ce que ça change
Une question que je poserai à tout projet de données, y compris les miens. Pas « qu'est-ce que l'analyse a trouvé », mais : qu'est-ce qu'elle a trouvé qu'on ne savait pas déjà, et comment le sait-on ?
C'est une question désagréable et elle est souvent utile. Beaucoup de projets de données produisent des conclusions que les gens du métier connaissaient. Ce n'est pas nécessairement un échec --- confirmer chiffres à l'appui une intuition contestée a de la valeur, notamment pour arbitrer. Mais il faut le dire, plutôt que de présenter comme une découverte ce qui est une confirmation.
Une exigence sur les études de cas que je produis. Dans mon propre travail de formation, je m'oblige désormais à trois lignes que l'exemple SportInter n'a pas : quelle était la situation avant, comment on isole l'effet du dispositif, ce qu'il coûte. Trois lignes. Elles transforment une démonstration en résultat.
Une nuance, pour être juste avec mon support. Le rôle d'un cas d'école n'est pas de démontrer la rentabilité d'un projet, c'est d'illustrer un enchaînement méthodologique. Sur ce plan, SportInter fait son travail : les six étapes deviennent lisibles, on voit ce que veut dire « préparer les données » ou « déployer ».
Ce que je lui reproche est plus étroit : il laisse penser que le résultat vient de la méthode. Une phrase suffirait à corriger --- « dans un projet réel, cette conclusion devrait être validée par un test A/B contre un groupe témoin ». Une phrase, encore. C'est la troisième fois que j'écris ça dans cette série, et je commence à me demander si ce n'est pas le vrai sujet du carnet : mes supports ne sont presque jamais faux, ils sont incomplets d'une phrase, toujours la même --- celle qui dirait comment on saurait qu'on s'est trompé.
Rattachement au référentiel
Cet épisode relève du sous-bloc BC2.6 --- Tester et optimiser une solution de relance par IA, dans le bloc 2 du titre RNCP40875, dont l'intitulé désigne très exactement le cas traité ici : une relance, et la question de savoir comment on la teste. Il croise BC2.1, puisque décider qu'un projet mérite d'être lancé suppose de savoir à quoi on comparera son résultat.
Prochain épisode : journal du mois 3.
Passer de la réflexion à la situation réelle
Ce sujet ressemble à quelque chose que vous vivez ?
Vous pouvez me décrire le contexte, ce qui résiste et ce qui devrait devenir plus clair. Nous verrons simplement si mon approche peut être utile.
Voir comment je peux aiderLes commentaires sont hébergés par Giscus et GitHub. Ils ne sont chargés qu’à votre demande.